Bark:Suno 开源的文本提示生成式音频模型
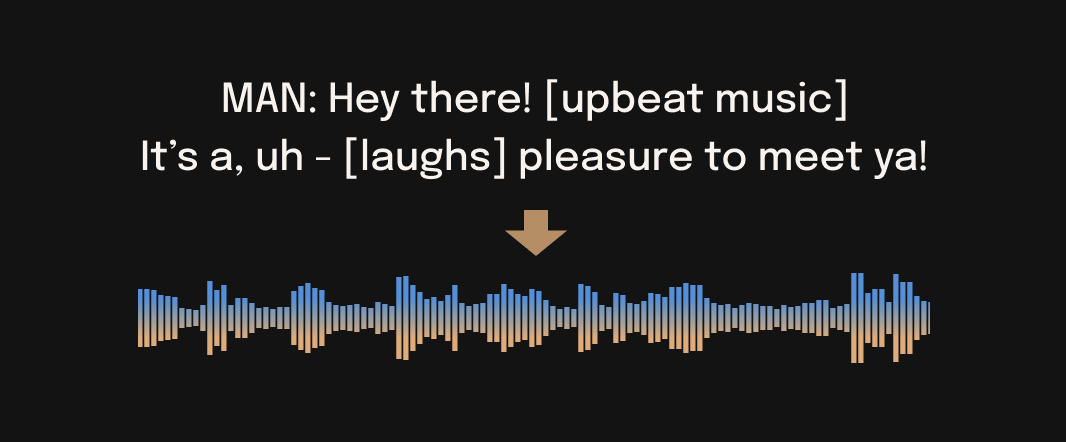
Bark 是 Suno 开发的基于 Transformer 的文本转音频开源模型,可生成高度逼真的多语言语音,也能生成音乐、背景噪声和简单音效,并支持笑声、叹气、哭泣等非语言发声。项目以 MIT 许可证开放预训练检查点,支持商业使用,提供 Python、命令行与 Hugging Face Transformers 三种使用方式。
社区作者 · zZz
它解决什么问题
Bark 是 Suno 创建并开源的文本转音频(text-to-audio)模型,采用 GPT 风格架构,参考了 AudioLM、Vall-E 的思路,并使用 EnCodec 的量化音频表示。与常规 TTS 不同,Bark 是“完全生成式”的文本到音频模型,输入文本直接转换为音频,不经过音素这一中间步骤,因此可以泛化到音乐歌词、音效和其他非语音声音,但也可能以难以预期的方式偏离给定脚本。
官方在页面中列出 Bark 的能力与特性:
- 生成多语言语音,并根据输入文本自动判断语言;面对语码混用(code-switched)文本时会尝试使用对应语言的母语口音,目前英语质量最好。
- 支持 100+ 说话人预设(speaker presets),覆盖受支持语言;Bark 会尝试匹配预设的音色、音高、情感和韵律,但当前不支持自定义声音克隆。
- 可生成音乐(官方建议在歌词两侧加 ♪ 帮助模型按音乐生成)、背景噪声、简单音效,以及笑声、叹气、哭泣等非语言声音。
- 默认 generate_audio 适合约 13 秒的口语文本,长文本生成需要参考官方 notebook。
已知可用的非语音控制标记(官方列出,并说明仍在持续发现更多):
- [laughter]、[laughs]、[sighs]、[music]、[gasps]、[clears throat]
- — 或 ... 表示犹豫停顿
- ♪ 用于歌词
- 全部大写用于强调某个词
- [MAN] 与 [WOMAN] 分别将 Bark 偏向男声和女声
支持语言(官方状态表均为 ✅):英语(en)、德语(de)、西班牙语(es)、法语(fr)、印地语(hi)、意大利语(it)、日语(ja)、韩语(ko)、波兰语(pl)、葡萄牙语(pt)、俄语(ru)、土耳其语(tr)、简体中文(zh)。
版本更新(来源明确记录):
- 2023.04.20:Bark 发布。
- 2023.05.01:改为 MIT 许可证,可商用;GPU 提速 2 倍、CPU 提速 10 倍;新增更小版本模型(有额外提速,但质量略低);新增 notebooks 章节记录长文本生成、声音一致性增强等示例;建立 voice prompt library;支持低显存 GPU(<4GB)。
硬件与推理速度:已在 CPU 和 GPU 上测试(PyTorch 2.0+,CUDA 11.7 与 CUDA 12.0)。在企业级 GPU 与 PyTorch nightly 上可接近实时生成;在较老 GPU、默认 Colab 或 CPU 上推理可能明显更慢,此时可考虑使用小模型。
免责声明:Bark 面向研究目的开发,不是传统 TTS,输出可能偏离提示词,Suno 不对生成内容负责,需自行承担使用风险并负责任地使用。
FAQ 要点:模型通过 Hugging Face 下载与缓存,缓存位置可查阅 Hugging Face 相关说明;输出与提示不一致是 GPT 风格模型的“创作自由”所致;不支持自定义声音克隆;输出长度约 13-14 秒与架构/上下文窗口有关;显存方面完整版约需 12GB,通过设置环境变量可用更小显存(低至约 2GB)运行。
— 本文由 AI 根据公开来源辅助整理,命令、版本与许可证请在使用前到原始页面复核。
安装 / 开始使用
官方明确警告:不要使用 pip install bark,那会安装另一个并非由 Suno 维护的包。
一、准备环境
Python 环境;已提供 PyTorch 2.0+(在 CPU 或 GPU 上均可运行,测试过的 CUDA 版本为 11.7 和 12.0)。
- 显存/内存:完整版 Bark 需要约 12GB VRAM 才能把所有组件同时放在 GPU 上;小版本模型约可放入 8GB VRAM;通过附加设置可在低至约 2GB 的显卡上运行(见第四部分)。
二、安装 Bark 方式 A(直接从 GitHub 安装):
pip install git+https://github.com/suno-ai/bark.git
方式 B(克隆后本地安装):
git clone https://github.com/suno-ai/barkcd bark && pip install .
三、首次运行(Python 基础用法)
- 导入并预加载模型(会自动下载并加载全部模型):
from bark import SAMPLE_RATE, generate_audio, preload_models
from scipy.io.wavfile import write as write_wav
from IPython.display import Audio

preload_models()- 由文本生成音频:
text_prompt = """
Hello, my name is Suno. And, uh — and I like pizza. [laughs]
But I also have other interests such as playing tic tac toe.
"""
audio_array = generate_audio(text_prompt)- 保存音频到磁盘:
write_wav("bark_generation.wav", SAMPLE_RATE, audio_array)- 在 notebook 中播放:
Audio(audio_array, rate=SAMPLE_RATE)四、显存不足时的设置 在生成代码之前加入以下代码片段(适用于约 8GB 以下、甚至低至约 2GB 的显卡):
import os
os.environ["SUNO_OFFLOAD_CPU"] = "True"
os.environ["SUNO_USE_SMALL_MODELS"] = "True"
仅使用小版本模型(约可放入 8GB VRAM)时,可设置环境变量:SUNO_USE_SMALL_MODELS=True。
五、命令行用法
python -m bark --text "Hello, my name is Suno." --output_filename "example.wav"六、通过 Hugging Face Transformers 使用(需 4.31.0 及以上版本)
- 从 main 安装 Transformers:
pip install git+https://github.com/huggingface/transformers.git - 加载处理器与模型:
from transformers import AutoProcessor, BarkModel

processor = AutoProcessor.from_pretrained("suno/bark")
model = BarkModel.from_pretrained("suno/bark")- 指定声音预设并生成:
voice_preset = "v2/en_speaker_6"
inputs = processor("Hello, my dog is cute", voice_preset=voice_preset)
audio_array = model.generate(**inputs)
audio_array = audio_array.cpu().numpy().squeeze()- 在 notebook 中播放:
from IPython.display import Audio
sample_rate = model.generation_config.sample_rate
Audio(audio_array, rate=sample_rate)- 或用第三方库(如 scipy)保存为 wav:
import scipy
sample_rate = model.generation_config.sample_rate
scipy.io.wavfile.write("bark_out.wav", rate=sample_rate, data=audio_array)
更多推理细节可参考官方 Bark 文档或 Google Colab 实操示例。
七、常见问题与注意事项
不要执行
pip install bark,那会装到非官方维护的其他包。
- 模型下载与缓存由 Hugging Face 负责,缓存路径信息可查阅 Hugging Face 文档。
- 生成结果有时与提示词不一致:Bark 是 GPT 风格模型,输出方差高于传统 TTS。
- 输出默认约 13-14 秒,这是架构/上下文窗口的优化长度;长文本需参考官方长文本生成 notebook。
- 当前不支持自定义声音克隆;声音预设库可在代码中或官方预设库页面浏览,社区也会在 Discord 分享预设。
- 语言会自动从输入文本识别,例如用德文历史提示配英文文本,通常会得到带德国口音的英文音频。
来源教程配图