Kedro:面向生产级数据工程与数据科学管道的 Python 工具箱
Kedro 是托管于 LF AI & Data Foundation 的开源 Python 框架,用软件工程最佳实践帮助团队构建可复现、可维护、模块化的数据工程与数据科学管道,提供项目模板、Data Catalog、管道抽象、编码规范与灵活部署等能力。
社区作者 · zZz
它解决什么问题
项目定位
Kedro 是一个面向生产级数据工程与数据科学管道的工具箱,目标是用软件工程最佳实践,帮助用户创建可复现(reproducible)、可维护(maintainable)、模块化(modular)的数据工程与数据科学管道。它是一个开源 Python 框架,由 LF AI & Data Foundation 托管,官网为 kedro.org。
主要特性
- **Project Template(项目模板)**:基于 Cookiecutter Data Science 的标准、可修改、易用的项目模板。
- **Data Catalog(数据目录)**:一组轻量级数据连接器,用于跨多种文件格式与文件系统保存和加载数据,覆盖本地与网络文件系统、云对象存储和 HDFS;同时对基于文件的系统提供数据与模型版本管理。
- **Pipeline Abstraction(管道抽象)**:自动解析纯 Python 函数之间的依赖关系,并可通过 Kedro-Viz 进行数据管道可视化。
- **Coding Standards(编码规范)**:使用 pytest 进行测试驱动开发,使用 Sphinx 产出文档完善的代码,借助 ruff 支持生成符合 lint 规范的代码,并使用标准 Python 日志库。
- **Flexible Deployment(灵活部署)**:部署策略涵盖单机或分布式机器部署,并额外支持在 Argo、Prefect、Kubeflow、AWS Batch 和 Databricks 上部署。
为什么存在
Kedro 的诞生源于团队在交付真实世界机器学习应用、处理大量未经校验的原始数据过程中的集体最佳实践(以及踩过的坑)。其目标包括:
- 解决 Jupyter notebook、一次性脚本和胶水代码的主要缺陷,把重点放在编写可维护的数据工程与数据科学代码上。
- 在不同成员对软件工程概念熟悉程度不一的情况下,增强团队协作。
- 通过模块化与关注点分离等实践,催生可复用分析代码,从而提高效率。
使用路径
官方文档先讲解如何安装 Kedro,随后介绍 Kedro 的核心概念;之后可以跟随 spaceflights 教程动手搭建一个 Kedro 项目。对初学者和中级用户,文档中有一整节讲解如何使用 Kedro-Viz 可视化 Kedro 项目。此外还有关于 Kedro 与 Jupyter notebook 配合使用的说明,以及针对关键特性的一组高级用户指南;官方也推荐查阅 API 参考文档。
配图说明
- 配图 1(Kedro):Kedro 仓库中的演示图示(demo-light.png)。
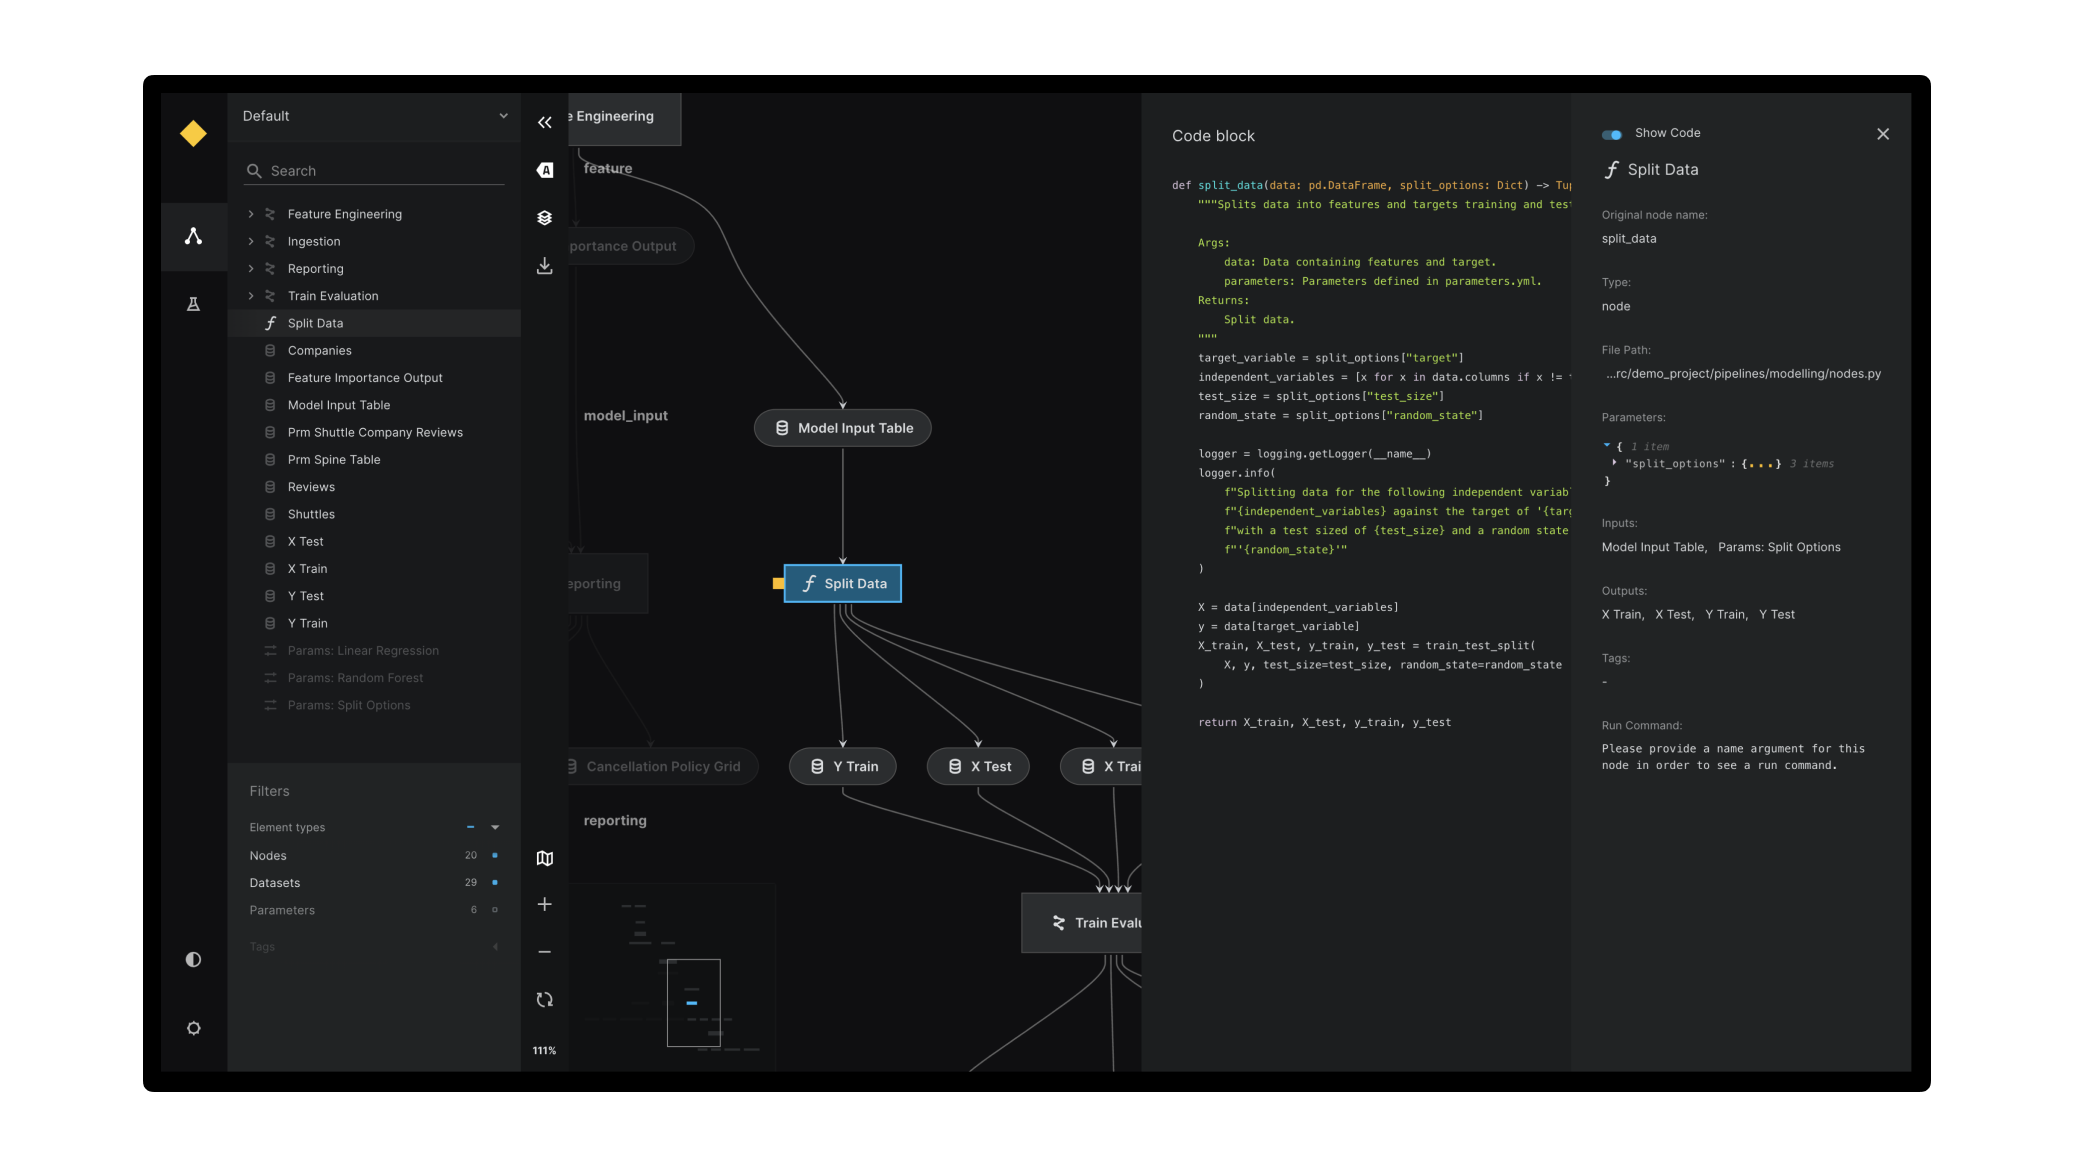
- 配图 2(教程配图):Kedro-Viz 项目的横幅图(banner.png)。正文在介绍 Kedro-Viz 时提到“A pipeline visualisation generated using Kedro-Viz”,即由 Kedro-Viz 生成的管道可视化图。
社区与支持
Kedro 由 Kedro 产品团队和来自全球的众多开源贡献者共同维护,欢迎各类贡献。社区持续成长,可在 Slack 上提问与回答技术问题,并可在 Linen 归档中查阅过往讨论;文档中维护了技术 FAQ 列表;awesome-kedro GitHub 仓库中汇集了博客、视频和使用 Kedro 的项目。Kedro 每两周举办一次公开的 Kedro Coffee Chat,分享更新与动态并留出实时提问时间,相关主题与日期见 Kedro Coffee Chat wiki 页面,公告与演示录像见 Slack 公告频道。
学术引用
对学术用户而言,Kedro 也可作为解决可复现研究问题的工具;可通过仓库的 “Cite this repository” 按钮,基于 CITATION.cff 文件生成引用。
— 本文由 AI 根据公开来源辅助整理,命令、版本与许可证请在使用前到原始页面复核。
安装 / 开始使用
以下步骤依据来源正文整理。
方式一:从 Python Package Index(PyPI)安装
- 准备 Python 环境。官方 Get Started 指南包含完整安装说明,其中包括如何设置 Python 虚拟环境。
- 在已激活的虚拟环境中执行:
uv pip install kedro方式二:使用 conda 安装
也可以使用 conda 安装 Kedro,执行:
conda install -c conda-forge kedro方式三:从源码安装(获取尚未正式发布的最新版本)
如需在正式发布前访问最新的 Kedro 版本,可从 main 分支安装:
uv pip install git+https://github.com/kedro-org/kedro@main安装后如何开始学习与使用
- 先阅读 Kedro 文档中“如何安装 Kedro”的部分,再了解 Kedro 的关键概念。
- 跟随 spaceflights 教程动手构建一个 Kedro 项目,获得实操经验。
- 新用户与中级用户可查阅关于使用 Kedro-Viz 可视化 Kedro 项目的完整章节。
- 另有文档说明如何将 Kedro 与 Jupyter notebook 配合使用,并提供针对关键 Kedro 特性的高级用户指南。
- 官方建议进一步查阅 API 参考文档。
常见问题与补充说明
若不确定应使用哪种安装方式:常规使用走 PyPI 或
conda;需要尚未发布的最新版本时再走 main 分支源码安装。
- 环境隔离:官方 Get Started 指南专门说明了 Python 虚拟环境的设置方法,建议在虚拟环境中安装。
- 代码质量工具链:项目模板与配套实践涉及 pytest(测试驱动开发)、Sphinx(文档)、ruff(lint)以及标准 Python 日志库。
Python 版本支持:核心 Kedro Framework 支持 CPython 核心团队仍在积极维护的所有 Python 版本;某个 Python 版本到达生命周期终点(end of life)后,Kedro 会停止对其支持,这不被视为破坏性变更。kedro-datasets 遵循 NEP 29 Python 版本支持政策,通常会比 kedro 更早放弃对某些 Python 版本的支持,原因在于 kedro-datasets 依赖众多且这些依赖遵循 NEP 29,而 Kedro Framework 更为保守的版本支持策略使其难以妥善管理这些依赖。
- 贡献与求助:欢迎各类贡献,可查阅 Kedro 贡献指南;技术问题可在 Slack 提问,历史讨论见 Linen 归档,文档中也有技术 FAQ。